Manutenção programada: atualizar com uma pausa controlada
Como preparar, executar e recuperar um deployment com interrupção planejada.
Atualizado em: 14 de novembro de 2026
Neste cenário, você aceita uma interrupção planejada para trocar a aplicação e, se necessário, a estrutura do banco. É o caminho mais direto quando a indisponibilidade cabe no acordo com o negócio.
O aviso visual não é a proteção: o bloqueio precisa alcançar API e todos os caminhos de escrita. Uma aba antiga, integração, job ou webhook pode continuar tentando operar.
Infraestrutura e preparação
- Página estática de manutenção no proxy, independente da aplicação atualizada; responder HTTP 503 e, quando apropriado, Retry-After.
- Acesso interno controlado para validação; nunca um parâmetro público que permita furar o bloqueio.
- Inventário de API, jobs, filas, agendadores, webhooks e integrações que escrevem no banco.
- Backup verificável, procedimento de restauração ensaiado e estimativa do tempo real da migração.
- Versão anterior preservada e procedimento de recuperação definido para código, configuração e dados.
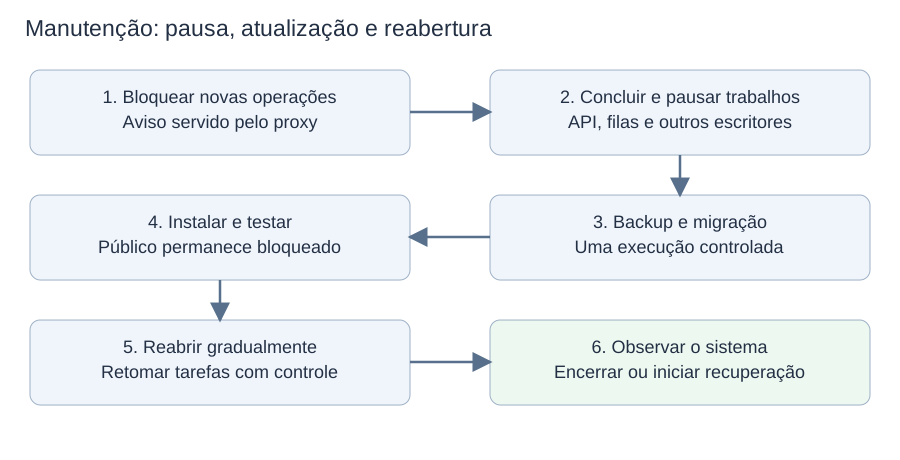
Falhas antes da reabertura mantêm o aviso ativo. Falhas depois da reabertura precisam considerar novas gravações legítimas.
Fluxo completo
- Antes da janela: homologar o build, ensaiar migração em dados representativos e comunicar a pausa e seu prazo estimado.
- Bloquear novas operações no proxy. Tratar webhooks conforme contrato: erro temporário só ajuda quando o provedor realmente tenta novamente; se necessário, receber e armazenar os webhooks em um serviço separado, para processá-los depois.
- Drenar requisições. Pausar novos jobs e consumo de filas, permitindo concluir tarefas em andamento. Se houver timeout, investigar antes de matar um processo que possa estar alterando dados.
- Confirmar que nenhum processo está gravando no banco e que não há transações pendentes relevantes. Um site bloqueado não garante banco parado.
- Gerar ponto de recuperação consistente, com a estratégia apropriada ao banco. Verificar que o backup foi concluído e é acessível.
- Executar a migração uma vez por tarefa exclusiva do pipeline. Registrar etapas aplicadas; não iniciar automaticamente de novo sem conhecer o estado.
- Instalar a versão nova e configuração correspondente. Verificar inicialização, logs, autenticação, leituras e operações de negócio.
- Validar escritas em conta/dados de teste controlados. Cobranças e notificações reais exigem isolamento ou compensação prevista.
- Decidir reabertura. Liberar atendimento e retomar agendadores/consumidores em ordem e com limites para evitar avalanche da fila acumulada.
- Observar erros, latência, fila e métricas de negócio. Registrar o fim da manutenção e manter material de recuperação pelo prazo definido.
Atualização do banco
Sem escritores ativos, é possível realizar uma troca incompatível com a aplicação antiga. Isso não torna a operação instantânea ou reversível. Adicionar NOT NULL, índices, converter tipos ou processar muitos registros pode falhar ou demorar.
Em MySQL, diversas operações de estrutura fazem commit implícito. Não assumir que envolver toda a migração em BEGIN permitirá desfazer tudo com ROLLBACK. O comportamento depende do motor, versão e comando; mesmo que uma instrução seja concluída por inteiro ou não tenha efeito, isso não garante que toda a sequência de migrações possa ser desfeita com ROLLBACK.
Falhas e recuperação por ponto
| Ponto | Ação e limite |
|---|---|
| Backup ou preparação falha, sem mudança aplicada | Cancelar a entrega, confirmar que a versão anterior está íntegra e reabrir. Não reabrir sem verificar se houve alguma modificação. |
| Migração em andamento ou parcialmente aplicada | Manter bloqueio. Inspecionar estado real, locks e histórico. Escolher continuação/correção ou recuperação ensaiada; não repetir cegamente nem matar DDL sem análise. |
| Migração concluída, aplicação nova não inicia | Se o banco aceita a aplicação antiga, voltar o código. Se não aceita, corrigir para frente ou recuperar estrutura/dados conforme o plano antes de reabrir. |
| Teste interno encontra erro | Manter manutenção; retornar ao ponto compatível ou produzir candidato corrigido. Novas alterações exigem validação proporcional. |
| Bug após reabertura, sem dados errados | Conter a função e voltar a aplicação se o banco permitir; caso contrário, patch ou manutenção corretiva. |
| Bug gravou dados errados | Interromper a origem, identificar janela e registros, preservar evidências e reparar seletivamente. Usar histórico/auditoria ou cópia restaurada. |
| Servidor falha durante a janela | O aviso só continua disponível se servido por infraestrutura sobrevivente. Recuperar a máquina ou destino alternativo e inspecionar o banco antes de retomar. |
Por que restaurar backup exige cuidado
Se todos os escritores ficaram parados desde o backup, restaurar aquele ponto pode ser viável, considerando dados de validação e efeitos externos. Depois da reabertura, restaurar o banco inteiro pode apagar pedidos corretos. Uma saída é restaurar uma cópia separada e extrair apenas os registros necessários; o procedimento deve preservar alterações posteriores legítimas. Pagamentos e mensagens externas não são desfeitos pela restauração.
Bugfix e hotfix
Uma correção comum entra na próxima janela. Uma correção urgente pode usar janela menor, mas precisa da mesma identificação de versão, teste do patch e avaliação do banco. Aplicar na linha afetada e rastrear sua incorporação à principal. Não reutilizar uma tag já publicada nem sobrescrever silenciosamente o pacote anterior.
Quando usar e quando mudar
É adequado quando a pausa é tolerável e o tempo de recuperação cabe no acordo. Se as janelas ficam longas, frequentes ou imprevisíveis, investigar migrações em etapas, melhorias no pipeline ou outra estratégia. Zero downtime não deve ser prometido neste cenário.
Fontes e aprofundamento
- MySQL — Operações com commit implícito
- AWS — Segurança de rollback
- NGINX — Controle e recarga graciosa
- RabbitMQ — Confirmações e reentrega
Referências consultadas em 2 de novembro de 2026. Os procedimentos são modelos conceituais: parâmetros, comandos e garantias dependem da tecnologia e precisam ser ensaiados.
Outros artigos da série
Compartilhe este artigo
Fontes e leituras adicionais
Este artigo é uma introdução prática, não substitui a documentação original. Confira as datas e os detalhes nas fontes antes de tomar decisões técnicas.
Coment?rios