Skills, MCP, RAG e Memory: um exemplo prático de uso
Entenda, por meio da investigação de um erro HTTP 500 no checkout, como Skills, MCP, RAG e Memory se complementam em agentes de IA.
Atualizado em: 14 de novembro de 2026
Agentes de IA conseguem interpretar instruções, analisar código e executar tarefas utilizando o conhecimento adquirido durante seu treinamento. Entretanto, esse conhecimento não é suficiente para compreender todas as particularidades de um projeto, acessar sistemas externos ou recuperar informações de execuções anteriores.
Para ampliar essas capacidades, podemos utilizar diferentes mecanismos, como Skills, MCP, RAG e Memory.
Embora frequentemente sejam apresentados como alternativas, esses recursos possuem responsabilidades distintas e podem trabalhar em conjunto.
A questão não é escolher uma única tecnologia, mas compreender qual informação ou capacidade o agente precisa, de onde ela deve vir e como disponibilizá-la no momento adequado.
Vamos utilizar um cenário de investigação de falhas em uma aplicação para demonstrar essas diferenças e como os quatro recursos podem ser combinados.
1. Entendendo as responsabilidades
Antes de analisar cada tecnologia, é importante estabelecer suas funções.
| Recurso | Responsabilidade principal | Exemplo |
|---|---|---|
| Skills | Definir procedimentos, instruções especializadas e critérios de execução | Procedimento para investigar falhas em produção |
| MCP | Padronizar o acesso a ferramentas, sistemas e fontes externas | Consultar logs, métricas e deployments |
| RAG | Recuperar informações relevantes de fontes de conhecimento | Consultar documentação arquitetural e contratos |
| Memory | Preservar informações úteis entre etapas, sessões ou execuções | Recuperar o histórico de um incidente anterior |
Essas definições representam responsabilidades predominantes, não limitações absolutas.
Uma Skill pode utilizar ferramentas, um servidor MCP pode oferecer acesso a mecanismos de busca, e um sistema de memória pode utilizar recuperação semântica.
A distinção está principalmente na finalidade de cada recurso.
2. Um cenário prático: erro HTTP 500 no checkout
Considere uma aplicação de ecommerce que começa a apresentar erros HTTP 500 durante a finalização de compras.
O objetivo do agente é investigar o problema, identificar sua provável causa e auxiliar na recuperação do serviço.
Para isso, ele pode precisar de diferentes tipos de informação:
- Procedimentos de investigação e resposta a incidentes.
- Logs e métricas atuais da aplicação.
- Histórico de deployments.
- Arquitetura e dependências do checkout.
- Contratos com serviços externos.
- Informações sobre incidentes semelhantes.
- Critérios para decidir quando solicitar intervenção humana.
Uma abordagem seria carregar todos os documentos, logs e históricos disponíveis diretamente na janela de contexto do modelo.
Entretanto, isso pode aumentar o consumo de tokens, introduzir informações irrelevantes e dificultar a identificação dos dados importantes.
Uma estratégia mais eficiente é disponibilizar recursos específicos e permitir que o agente consulte cada um conforme a necessidade.
3. Skills: definindo procedimentos e critérios de execução
Uma Skill é um conjunto de instruções especializadas que orienta o agente na realização de determinada categoria de tarefa.
Ela pode conter procedimentos, regras, exemplos, referências e scripts auxiliares.
Em sistemas que suportam descoberta e carregamento progressivo, o agente pode identificar as Skills disponíveis e carregar suas instruções completas somente quando necessário.
Esse mecanismo evita incluir todos os procedimentos na janela de contexto em cada execução.
Exemplo: Skill de investigação de incidentes
Para investigar o problema do checkout, podemos definir uma Skill com um procedimento semelhante a:
---
name: incident-triage
description: Investiga incidentes de aplicações em produção.
---

# Incident Triage

1. Identificar o serviço e o ambiente afetado.
2. Consultar a taxa de erros e o período de início.
3. Verificar deployments e alterações recentes.
4. Investigar logs e dependências relacionadas.
5. Consultar a documentação arquitetural relevante.
6. Formular hipóteses com base nas evidências.
7. Propor ações de correção e validação.

## Restrições

- Não modificar ambientes de produção sem autorização.
- Não executar ações destrutivas automaticamente.
- Não expor credenciais ou dados sensíveis.
- Escalar incidentes críticos ao responsável técnico.
- Registrar evidências e resultados da investigação.
Essa Skill não precisa conter todos os detalhes arquiteturais do checkout nem armazenar os logs da aplicação.
Sua responsabilidade é estabelecer como conduzir a investigação.
Também pode definir critérios para interromper a execução, solicitar informações adicionais ou encaminhar o problema a um responsável.
Quando utilizar Skills
Skills são úteis quando existem procedimentos específicos que devem ser reproduzidos de maneira consistente.
Exemplos:
- Investigação de incidentes.
- Revisão de segurança.
- Preparação de releases.
- Migrações de banco de dados.
- Geração de documentação em um formato específico.
- Validação de entregas.
Entretanto, não é necessário transformar toda tarefa em uma Skill.
Agentes modernos já possuem conhecimento para realizar diversas atividades comuns. Skills devem acrescentar instruções, procedimentos ou recursos que realmente façam diferença.
Skills orientam a execução, mas não garantem, por si só, acesso aos sistemas necessários.
4. MCP: conectando agentes a ferramentas e sistemas
O Model Context Protocol (MCP) é um protocolo aberto que padroniza a integração entre aplicações de IA e sistemas externos.
Sua arquitetura envolve hosts, clientes e servidores MCP.
O host é a aplicação que coordena a experiência do agente. Os clientes estabelecem conexões com servidores MCP, que podem disponibilizar ferramentas, recursos e prompts.
No cenário do checkout, o agente precisa consultar informações que não estão presentes em seu contexto inicial.
Por exemplo:
- Logs do backend.
- Taxa de erros HTTP 500.
- Métricas de infraestrutura.
- Histórico de deployments.
- Status de serviços externos.
Um servidor MCP pode disponibilizar ferramentas como:
get_service_metrics(service, period)

search_application_logs(service, query)

list_recent_deployments(service)

get_deployment_details(deployment_id)
Os nomes são ilustrativos.
Ao identificar a necessidade de verificar a taxa de erros, o agente pode utilizar a ferramenta apropriada para recuperar dados atuais da aplicação.
Isso permite que a investigação utilize evidências reais, em vez de depender exclusivamente do conhecimento do modelo.
MCP não substitui a implementação das integrações
É importante compreender que MCP é um protocolo de integração.
O servidor MCP ainda precisa implementar a comunicação com os sistemas externos, administrar autenticação e disponibilizar as operações permitidas.
Também não é obrigatório utilizar MCP para oferecer ferramentas a um agente. Integrações diretas e function calling podem atender diversas aplicações.
MCP se torna especialmente interessante quando buscamos padronização, reutilização e interoperabilidade entre diferentes aplicações e ferramentas.
Segurança e permissões
Disponibilizar uma ferramenta não significa que o agente deva receber acesso irrestrito.
Uma arquitetura adequada pode separar permissões de leitura, diagnóstico e modificação.
Por exemplo, consultar logs pode ser permitido durante a investigação, enquanto executar um rollback deve exigir autorização específica.
MCP oferece uma interface padronizada para acessar capacidades externas. A autorização para utilizá-las continua sendo responsabilidade da aplicação e de seus controles de segurança.
5. RAG: recuperando conhecimento relevante
Mesmo com acesso aos logs e às métricas, o agente pode não compreender completamente o funcionamento do sistema.
Imagine que os registros indiquem falhas durante a comunicação com o serviço de pagamentos.
Para interpretar o problema, o agente precisa conhecer a arquitetura do checkout, seus contratos e as responsabilidades de cada componente.
Essas informações podem estar distribuídas entre documentos técnicos, especificações e bases de conhecimento.
RAG (Retrieval-Augmented Generation) permite recuperar informações relevantes de fontes externas e incorporá-las ao contexto utilizado pelo modelo.
Exemplo: documentação arquitetural
Considere os seguintes documentos:
architecture/
  checkout-flow.md
  service-dependencies.md

contracts/
  payment-api.md
  order-status.md

integrations/
  payment-provider.md
Ao identificar uma falha relacionada a pagamentos, o agente pode recuperar os documentos correspondentes.
Esses documentos podem esclarecer que:
- O backend é responsável pela criação dos pagamentos.
- A atualização de determinados estados depende da confirmação do provedor.
- Webhooks podem ser entregues mais de uma vez.
- Uma falha no provedor não deve produzir cobranças duplicadas.
- Determinadas operações possuem políticas específicas de retry.
Essas informações ajudam o agente a interpretar os logs e evitar recomendações incompatíveis com as regras do sistema.
RAG não exige necessariamente um banco vetorial
Uma simplificação comum é associar RAG exclusivamente a embeddings e bancos de dados vetoriais.
Na prática, a recuperação pode utilizar diferentes mecanismos:
- Busca por palavras-chave.
- Busca full-text.
- Busca semântica com embeddings.
- Busca híbrida.
- Consultas estruturadas.
- Outras estratégias de seleção de informações relevantes.
A recuperação também pode envolver reranking para melhorar a seleção dos documentos.
O mecanismo deve ser escolhido conforme os dados disponíveis, as características das consultas e os requisitos da aplicação.
Essa decisão é aprofundada no artigo No Retrieval, Keyword Search, Vector Index e Vector Database: quando utilizar cada abordagem.
RAG e documentação de contexto
Em projetos de software, sistemas como o CHAOS podem organizar o conhecimento canônico sobre arquitetura, contratos, regras de negócio e integrações.
RAG pode ser utilizado para localizar e recuperar partes relevantes desse conhecimento.
São responsabilidades complementares: uma estrutura organiza e mantém a documentação, enquanto o mecanismo de recuperação disponibiliza informações conforme a necessidade.
RAG fornece conhecimento relevante para a tarefa, sem exigir que toda a documentação seja carregada antecipadamente.
6. Memory: preservando contexto e experiências anteriores
Durante a investigação, o agente pode descobrir informações que serão úteis em execuções futuras.
Por exemplo, um incidente anterior pode ter apresentado sintomas semelhantes e ter sido causado por uma configuração incorreta de timeout entre o checkout e o provedor de pagamentos.
Essa informação pode não estar presente na documentação arquitetural original.
Um mecanismo de memória permite preservar conhecimentos, decisões, resultados e estados relevantes além de uma interação isolada.
Diferentes tipos de memória
Memória não representa necessariamente uma única base de dados ou tecnologia.
Podemos distinguir diferentes necessidades:
Memória de execução
Preserva informações necessárias durante o andamento de uma tarefa, como hipóteses investigadas, resultados de ferramentas e etapas pendentes.
Memória entre sessões
Permite recuperar informações úteis quando o trabalho continua em uma nova sessão, sem depender exclusivamente do histórico completo da conversa.
Memória de experiências anteriores
Registra conhecimentos aproveitáveis em situações futuras, como incidentes resolvidos, limitações descobertas e procedimentos que demonstraram bons resultados.
Essas categorias podem ser implementadas de maneiras diferentes, utilizando arquivos, bancos de dados, checkpoints ou mecanismos de recuperação.
Exemplo: histórico de incidentes
Considere um registro estruturado:
{
  "incident": "checkout-payment-timeout",
  "symptoms": [
    "HTTP 500 during checkout",
    "Payment provider timeout"
  ],
  "confirmed_cause": "Incorrect timeout configuration",
  "resolution": "Configuration adjusted and validated",
  "status": "resolved",
  "validated": true
}
Em uma investigação futura, o agente pode recuperar esse registro e utilizá-lo como referência.
Entretanto, isso não significa que a causa anterior seja necessariamente a causa do incidente atual.
O histórico deve auxiliar na formulação de hipóteses, não substituir a investigação.
Memória não deve armazenar tudo
Registrar indiscriminadamente conversas, respostas e observações pode criar problemas de qualidade e manutenção.
Uma memória útil precisa de critérios para:
- Selecionar informações relevantes.
- Evitar duplicações.
- Identificar a origem dos registros.
- Distinguir hipóteses de fatos confirmados.
- Atualizar ou invalidar informações desatualizadas.
- Respeitar permissões e requisitos de privacidade.
Também é importante diferenciar memória operacional de documentação canônica.
Uma descoberta confirmada que modifica o entendimento oficial do sistema pode precisar ser incorporada à documentação permanente, e não permanecer apenas na memória do agente.
Memory versus RAG
A distinção não depende exclusivamente de quem escreveu a informação.
Uma memória pode conter preferências fornecidas por um usuário, estados de execução, decisões ou resultados aprendidos pelo agente.
Da mesma forma, RAG pode recuperar documentos criados automaticamente ou registros derivados de execuções anteriores.
A diferença está principalmente na responsabilidade:
- RAG: recuperar informações relevantes de fontes externas para fundamentar a execução.
- Memory: preservar e disponibilizar informações que precisam continuar acessíveis entre interações ou execuções.
Esses mecanismos podem compartilhar tecnologias de armazenamento e recuperação.
Memory oferece continuidade, mas informações armazenadas precisam ser verificadas antes de orientar novas decisões.
7. Combinando Skills, MCP, RAG e Memory
Agora podemos reunir os quatro recursos na investigação do erro HTTP 500.
O fluxo não precisa seguir uma sequência rígida. O agente pode alternar entre ferramentas, documentação e memória conforme as evidências encontradas.
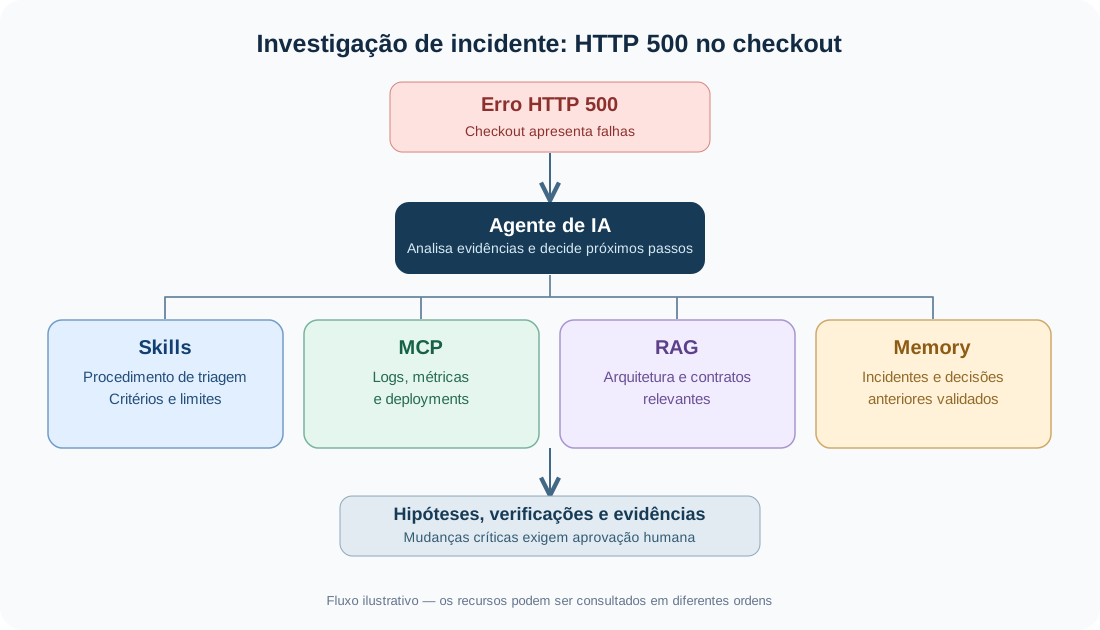
Exemplo conceitual: os quatro recursos colaboram com o agente, mas a autorização para alterações críticas permanece sob controle humano.
Uma execução possível:
| Etapa | Recurso | Ação |
|---|---|---|
| 1 | Skills | Carrega o procedimento de investigação de incidentes |
| 2 | MCP | Consulta métricas e identifica o início das falhas |
| 3 | MCP | Recupera logs e deployments recentes |
| 4 | RAG | Consulta contratos e dependências do checkout |
| 5 | Memory | Recupera incidentes anteriores com sintomas semelhantes |
| 6 | Agente | Compara evidências e formula hipóteses |
| 7 | MCP | Executa verificações adicionais permitidas |
| 8 | Skills | Aplica critérios de validação e escalonamento |
| 9 | Memory | Registra conclusões confirmadas para consultas futuras |
A correção em produção, caso necessária, permanece sujeita às permissões e aprovações estabelecidas.
O papel de cada recurso no fluxo
A Skill orienta a investigação e estabelece limites.
MCP permite acessar dados atuais e executar operações autorizadas.
RAG recupera conhecimento técnico sobre o sistema.
Memory acrescenta continuidade e experiências anteriores.
O agente combina essas informações para determinar os próximos passos.
O importante é que nenhum dos quatro recursos substitui a necessidade de validar resultados ou supervisionar operações críticas.
Uma Skill pode estar desatualizada, um servidor MCP pode retornar dados incompletos, a recuperação documental pode selecionar informações inadequadas e a memória pode conter conclusões que já não se aplicam.
A qualidade da execução depende também dos mecanismos de avaliação, permissões e tratamento de falhas.
8. Evitando sobreposição e complexidade desnecessária
Embora possam funcionar juntos, não é necessário implementar os quatro recursos em toda aplicação.
A escolha deve partir das necessidades reais do agente.
Quando utilizar cada recurso
| Necessidade | Recurso a considerar |
|---|---|
| Definir um procedimento especializado e reutilizável | Skills |
| Integrar ferramentas e sistemas externos por uma interface padronizada | MCP |
| Recuperar documentação e informações relevantes | RAG |
| Preservar estados, decisões e experiências entre execuções | Memory |
Essas escolhas não são exclusivas.
Por exemplo, uma Skill pode orientar um agente a recuperar determinados documentos por RAG e consultar ferramentas disponibilizadas por MCP.
Da mesma forma, um sistema de memória pode utilizar embeddings para recuperar experiências anteriores.
Evitando duplicação de responsabilidades
Um problema frequente é espalhar a mesma informação entre Skills, prompts, documentos, ferramentas e memória.
Considere uma regra que estabelece que a confirmação de pagamentos deve ser processada exclusivamente pelo backend.
Essa regra pertence ao conhecimento canônico do sistema.
A Skill responsável por investigar pagamentos pode referenciar essa documentação, em vez de manter uma cópia independente da regra.
Da mesma forma, a memória pode registrar que determinado incidente envolveu essa regra, mas não deve criar uma versão concorrente dela.
Essa separação reduz inconsistências e facilita a manutenção.
Evitando consumo desnecessário de contexto
A utilização de recursos externos não elimina automaticamente problemas de consumo de tokens.
Um agente ainda pode carregar Skills desnecessárias, executar consultas redundantes, recuperar documentos excessivamente longos ou incluir históricos irrelevantes.
Uma estratégia eficiente deve considerar:
- Carregamento de instruções conforme a tarefa.
- Recuperação seletiva de informações.
- Limitação e classificação dos resultados.
- Reutilização de dados quando apropriado.
- Controle do número de chamadas a ferramentas.
- Critérios para encerrar buscas sem progresso.
A arquitetura deve permitir que o agente obtenha informações suficientes para executar a tarefa, sem transformar cada interação em uma operação extensa e custosa.
9. Segurança, validação e manutenção
Ao combinar diferentes fontes de informação e execução, também aumentamos as responsabilidades de segurança e governança.
Instruções não confiáveis
Logs, documentos recuperados, mensagens de usuários reproduzidas nessas fontes e respostas de ferramentas podem conter conteúdo incorreto ou malicioso.
O agente não deve tratar esse material como instruções com a mesma autoridade de suas regras operacionais.
Isso é especialmente importante para reduzir riscos de prompt injection.
Controle de acesso
Ferramentas e fontes de conhecimento devem respeitar as permissões do usuário e do ambiente de execução.
Uma consulta documental não deve expor informações de outro projeto ou organização apenas porque o agente consegue acessar o mecanismo de busca.
Validação de resultados
Informações recuperadas de RAG ou Memory devem ser interpretadas conforme sua origem, atualização e confiabilidade.
Recomendações que alterem infraestrutura, segurança ou dados de produção exigem verificações proporcionais ao risco.
Manutenção do conhecimento
Os quatro recursos precisam acompanhar a evolução do sistema.
- Skills devem ser revisadas quando os procedimentos mudarem.
- Integrações MCP precisam continuar compatíveis com os sistemas externos.
- Fontes de RAG devem refletir a documentação vigente.
- Registros de memória devem permitir correção, atualização ou invalidação.
Uma arquitetura sofisticada não compensa procedimentos incorretos ou informações desatualizadas.
Conclusão
Skills, MCP, RAG e Memory representam mecanismos diferentes para ampliar as capacidades de agentes de IA.
Skills organizam procedimentos e instruções especializadas. MCP padroniza integrações com ferramentas e sistemas externos. RAG recupera conhecimentos relevantes. Memory preserva informações que precisam continuar disponíveis ao longo do trabalho.
Esses recursos podem ser utilizados individualmente ou combinados, dependendo da complexidade e dos requisitos da aplicação.
Em um processo de investigação de incidentes, por exemplo, o agente pode seguir uma Skill, consultar métricas por MCP, recuperar a arquitetura por RAG e utilizar informações validadas de incidentes anteriores por meio da memória.
A combinação permite trabalhar com procedimentos definidos, informações atuais, conhecimento técnico e continuidade entre execuções.
O objetivo não é oferecer ao agente a maior quantidade possível de informações, mas disponibilizar o conhecimento e as capacidades corretas, no momento necessário e com os controles adequados.
Referências e leituras adicionais
- Agent Skills — Specification — estrutura e utilização de Skills.
- Model Context Protocol — arquitetura, ferramentas, recursos e integrações MCP.
- Microsoft — Retrieval-Augmented Generation — fundamentos e organização de mecanismos de recuperação.
- LangGraph — Persistence — persistência e continuidade da execução de agentes.
- OWASP — Prompt Injection Prevention Cheat Sheet — proteção contra instruções maliciosas em conteúdos externos.
- CHAOS — Context for Human-AI Organization of Systems — organização do conhecimento canônico para humanos e agentes.
Artigos relacionados da série
- Harnesses, skills, ferramentas e MCP
- Arquitetura, engenharia e documentação de contexto
- Memória e continuidade do trabalho com agentes de IA
- CHAOS: organizando o contexto de projetos para humanos e agentes de IA
- No Retrieval, Keyword Search, Vector Index e Vector Database: quando utilizar cada abordagem
- Proteção de contexto e dados sensíveis
Compartilhe este artigo
Fontes e leituras adicionais
Este artigo é uma introdução prática, não substitui a documentação original. Confira as datas e os detalhes nas fontes antes de tomar decisões técnicas.